Agenti e decisione
AI locale su un portatile
Il banco di prova che dice quali modelli aperti reggono un lavoro vero su 8 GB di scheda video.
- Stato
- Prototipo
- Fase
- Strumento interno
- Anno
- 2026
- Demo
- Da provare
Il problema
Le PMI non possono mandare i dati dei clienti su server esterni, ma non sanno cosa gira davvero in sede. Le classifiche online misurano test generici, non il loro lavoro.
La soluzione
Provo i modelli aperti sul compito vero di un agente, sullo stesso PC, e dico quali reggono il lavoro di una PMI senza mandare dati fuori.
Perché conta
Le classifiche online usano test generici. A una PMI interessa se il modello rispetta le regole nel suo lavoro, e si scopre solo provandolo.
Come funziona
Progressi
Solo numeri misurati o scritti nei documenti di progetto.
A chi serve
PMI con dati sensibili
Scegliere il modello giusto da tenere in sede.
Dati sanitari
Lavorare su dati delicati senza che escano dall'azienda.
Costi
Sostituire le chiamate a pagamento dove un modello locale basta.
A che punto è
Fase
Strumento interno
Serve a me e agli altri progetti: si misura su quanto lavoro toglie.
Cosa non fa
- Non è una classifica generale dei modelli.
- Non prova modelli che non entrano in 8 GB più 16 GB di RAM.
Prossimo passo
Lo stesso test su 100 casi reali invece di 12.
Provalo
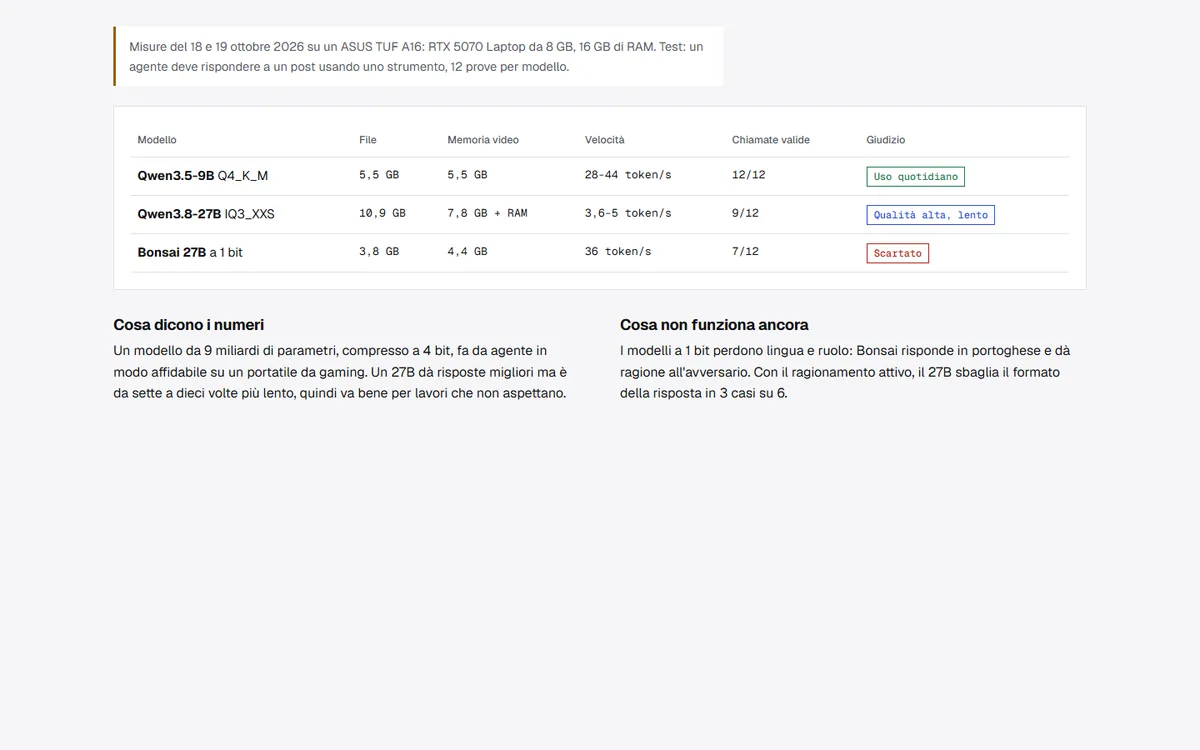
Misure del 18 e 19 ottobre 2026 su un ASUS TUF A16: RTX 5070 Laptop da 8 GB, 16 GB di RAM. Test: un agente deve rispondere a un post usando uno strumento, 12 prove per modello.
| Modello | File | Memoria video | Velocità | Chiamate valide | Giudizio |
|---|---|---|---|---|---|
| Qwen3.5-9B Q4_K_M | 5,5 GB | 5,5 GB | 28-44 token/s | 12/12 | Uso quotidiano |
| Qwen3.8-27B IQ3_XXS | 10,9 GB | 7,8 GB + RAM | 3,6-5 token/s | 9/12 | Qualità alta, lento |
| GLM-4.7-Flash 30B-A3B, Q3_K_XL | 13,8 GB | 6,4 GB + RAM | 7-40 token/s | 12/12 | Esce dal ruolo |
| Bonsai 27B a 1 bit | 3,8 GB | 4,4 GB | 36 token/s | 7/12 | Scartato |
Cosa dicono i numeri
Un modello da 9 miliardi di parametri, compresso a 4 bit, fa da agente in modo affidabile su un portatile da gaming. Un 27B dà risposte migliori ma è da sette a dieci volte più lento, quindi va bene per lavori che non aspettano.
Cosa non funziona ancora
I modelli a 1 bit perdono lingua e ruolo: Bonsai risponde in portoghese e dà ragione all'avversario. Con il ragionamento attivo, il 27B sbaglia il formato della risposta in 3 casi su 6. GLM-4.7-Flash rispetta sempre il formato ma in 2 commenti su 4 dà ragione all'avversario.
Vuoi sapere come funziona?
Qui racconto cosa fa e per chi. Come è costruito lo spiego volentieri a voce. Il codice è privato.